Mein ehrlicher Einstieg in LoRA-Training: Was ich als Anfänger wirklich hätte wissen wollen
Von Ria – zwischen Neugier, Testwahnsinn und einigen sehr vermeidbaren Fehlern.
Warum mich LoRA-Training anfangs mehr verwirrt als begeistert hat
Als ich angefangen habe, mich ernsthaft mit eigenen LoRAs (11/2025) zu beschäftigen, wirkte vieles erstmal unnötig kompliziert.
Und ich habe probiert mit wenig Erfolg.
Rank? Alpha? Steps? Epochs? Learning Rate? Bucket Mode? Checkpoints?
Gefühlt hatte jedes Tutorial zehn Menüs offen, sprach über perfekte Settings – aber kaum jemand erklärte sauber, was für Einsteiger wirklich wichtig ist.
Mein erster Denkfehler:
„Ich brauche nur starke Hardware und hohe Werte, dann wird die LoRA automatisch gut.“
Spoiler: Nein.
Die Realität ist deutlich praktischer. Aber wenn man lokal und ohne Kosten testen will hilft es ungemein 😉
Gute LoRAs entstehen vor allem durch:
- sauberes Dataset
- sinnvolle Captions
- passenden Base Checkpoint
- moderate Trainingswerte
- nachvollziehbare Dokumentation
Nicht durch blindes Hochdrehen aller Regler.
Wichtig: Das hier ist kein HowTo. Sondern ein KnowBefore. Das heißt erstmal überblicken und dann testen.
Die wichtigsten Begriffe – endlich verständlich
Rank (Linear Rank)
Rank bestimmt vereinfacht gesagt, wie viel Detail deine LoRA speichern kann.
Niedriger Rank:
- kleinere Datei
- weniger VRAM
- stabiler
- gut für Stil
Höherer Rank:
- mehr Details
- besser für Charaktere
- größer
- mehr Overfit-Risiko
Meine Praxis:
Für Stil / Coloring:
Rank 8–16
Für Charaktere:
Rank 16–32
Für mich als Anfänger:
Rank 16 war meist der beste Sweet Spot.
Steps & Epochs
Epoch:
Ein kompletter Durchlauf durch alle Bilder.
Steps:
Die tatsächlichen Trainingsschritte.
Faustregel:
Mehr Steps = längeres Training
Aber:
Mehr Steps = nicht automatisch bessere Qualität.
Zu viele Steps führen schnell zu Overfitting:
- Bilder ähneln Trainingsdaten zu stark
- Flexibilität sinkt
- Trigger wird „zu eng“
Mein Learning:
Lieber 2000–3000 saubere Steps testen als direkt 10.000 verschwenden.
Learning Rate (LR)
Die Learning Rate steuert, wie aggressiv dein Modell lernt.
Zu hoch:
- Artefakte
- instabiles Training
- Qualität bricht
Zu niedrig:
- extrem langsam
- ineffizient
Solider Start:
0.0001
Sicherer:
0.00005
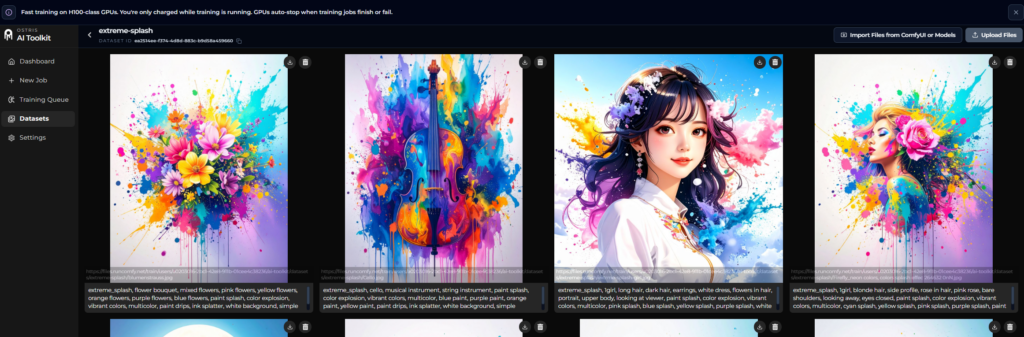
Der größte Anfängerfehler: Dataset unterschätzen
Ich dachte anfangs oft:
„Das Modell regelt den Stil schon.“
Tatsächlich gilt:
Dataset schlägt Modellwahl erstaunlich oft.
Ein gutes SDXL-LoRA kann besser performen als ein schlechtes FLUX-LoRA.
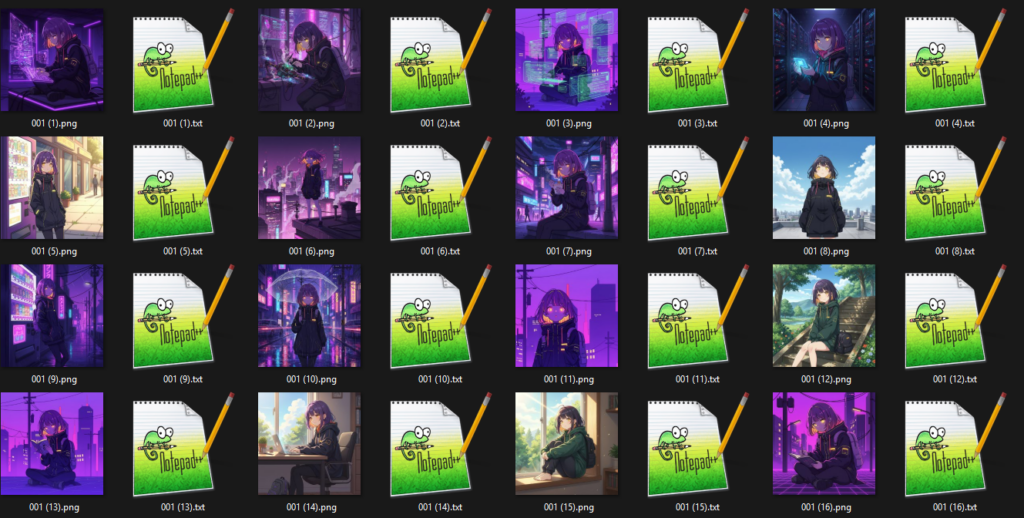
Wichtiger als Masse:
- einheitlicher Stil
- saubere Qualität
- keine Bildfehler
- klare Motive
- gute Wiedererkennbarkeit
Checkpoint: Warum das Basis-Modell extrem wichtig ist
Das war für mich ein echter Aha-Moment.
Die LoRA ist kein vollständiges Modell.
Sie ergänzt nur den Base Checkpoint.
Ergebnis:
Checkpoint + LoRA = finaler Stil
Bedeutet konkret:
Trainierst du auf einem stark stilisierten Anime-Checkpoint:
- Deine LoRA wird stark daran gebunden
- Andere Modelle liefern oft schlechtere Ergebnisse
Mein Fazit:
Für Branding & Serien:
Ein fester guter Base ist sinnvoll.
Für universelle LoRAs:
Neutralere Basismodelle wählen.
SDXL vs FLUX vs Qwen / Z-Image
SDXL
Vorteile:
- günstiger
- schneller
- stabil
- große Community
- ideal zum Lernen
Nachteile:
- weniger High-End
Mein Eindruck:
Perfekter Einstieg.
FLUX
Vorteile:
- Premium-Qualität
- starke Promptlogik
- sehr hochwertig
Nachteile:
- teuer
- langsam
- hoher VRAM-Bedarf
Mein Eindruck:
Spannend für Premium-Projekte, aber nicht ideal zum Lernen.
Qwen / Z-Image
Vorteile:
- modern
- experimentell
Nachteile:
- weniger Standardisierung
- weniger Tutorials
- mehr Unsicherheit
Mein Eindruck:
Eher Testfeld als Anfängerbasis.
VRAM & Dauer – was wirklich teuer wird
Größte Faktoren:
Stark relevant:
- Modelltyp
- Batch Size
- Bildgröße
- Rank
Weniger relevant:
- Learning Rate
Mein Learning:
Batch Size ist ein echter VRAM-Killer.
Batch 1 ist für viele lokale Systeme deutlich realistischer.
Mein ComfyUI Reality Check
ComfyUI ist großartig für:
- Datensätze bauen
- Generierung
- Captioning
- Tests
Aber:
Der Train Node fühlte sich für mich eher wie ein Testsystem an.
Probleme:
- Bucket Bugs
- Metadaten teils schwach
- Reproduzierbarkeit begrenzt
- mehr Fehlersuche
Mein ehrliches Fazit:
ComfyUI:
Gut für schnelle Tests
OneTrainer:
Besser für ernsthafte Produktion
Warum Metadaten plötzlich extrem wichtig wurden
Nach mehreren Test-LoRAs wurde schnell klar:
Ohne Logging verliert man komplett den Überblick.
Deshalb sinnvoll:
Zu jeder LoRA speichern:
- Base Model
- Rank
- Steps
- Learning Rate
- Dataset
- Trigger
- Datum
Beispiel:
{

"rank": 16,

"steps": 3000,

"learning_rate": 0.0001,

"base_model": "SDXL",

"trigger": "witch_academy"

}
Mein realistischer Anfänger-Fahrplan
Phase 1:
SDXL lernen
- Rank 16
- 2000–3000 Steps
- sauberes Dataset
- einfache Trigger
Phase 2:
Workflow professionalisieren
- JSON Logging
- OneTrainer
- Sample-Vergleiche
- Serienproduktion
Phase 3:
Premium
- FLUX
- größere Projekte
- Markenstil
Die größte Wahrheit
LoRA-Training ist weniger Magie als Prozesskontrolle.
Wer:
- sauber testet
- dokumentiert
- Datensätze ernst nimmt
- nicht blind Werte maximiert
…kommt meist deutlich schneller zu guten Ergebnissen.
Rias ehrliches Schlusswort
Am Anfang wirkte LoRA-Training für mich wie ein chaotischer Technik-Dschungel.
Heute sehe ich es eher so:
Gute LoRAs entstehen nicht durch perfekte Geheimsettings, sondern durch saubere Entscheidungen.
Wenn du gerade startest:
Mein Rat:
- Fang mit SDXL an
- Halte deine Settings simpel
- Dokumentiere alles
- Verbrenne nicht unnötig GPU-Zeit
- Investiere mehr Energie ins Dataset als in Hyperparameter-Panik
TL;DR
Starte einfach:
- SDXL
- Rank 16
- 3000 Steps
- LR 0.0001
- Batch 1
- gutes Dataset
Später:
- OneTrainer
- FLUX
- komplexere Produktionen
Der wichtigste Fortschritt kommt meist nicht durch größere Zahlen – sondern durch bessere Prozesse.


